
開始閱讀
AI 原理入門系列|第 2 篇,共 10 篇。資料核對:2026-10-09。文中的情境與練習為教學示例。
一個模型把練習題全部答對,就代表它會處理新問題嗎?不一定。它可能學到可重複使用的規律,也可能只是抓住練習資料裡的巧合。理解訓練與評估的差別,有助於判斷一個 AI 展示究竟有多可靠。
訓練是在反覆調整參數
以預測活動報名人數為例,模型先根據輸入產生預測,再用損失函數衡量預測與目標的差距。訓練演算法依據這個差距調整參數,反覆進行。損失函數決定了模型努力改善的方向,但不保證這個方向等同於業務真正重視的結果。
例如,團隊在意的是避免低估場地需求,卻只看平均誤差,就可能忽略少數嚴重低估的場次。定義「怎樣才算好」和選擇模型同樣重要。
圖解:資料分工:訓練、驗證、測試
訓練集、驗證集與測試集各做什麼
訓練集用於學習;驗證集協助選擇模型與調整設定;測試集保留到評估時,檢查對未見資料的表現。若反覆看測試結果再修改,測試集也會逐漸變成調整依據,失去原本的獨立性。Google 的資料切分教材說明了三者的用途。
可以把它想成教材、模擬練習與最後評量,但這只是類比:模型不是學生,分割資料也不會自動確保評估公平。
過度擬合:把偶然線索當成規律
假設過去成功活動的圖片剛好都有藍色邊框,模型可能把邊框當成強烈訊號。然而真正影響報名的是主題、受眾或時間。當新活動換了視覺風格,預測就失準。
過度擬合常見的警訊,是訓練表現持續變好,未見資料上的表現卻沒有同步改善。處理方向包括檢查資料、降低不必要的複雜度、使用正則化,或在合適時機停止訓練;不能只靠多跑幾輪解決。Google 的訓練調校指南提供相關判斷方法。
教學與行銷資料怎麼切才合理
本站練習案例:同一場講座有五張相似照片,若四張放訓練、一張放測試,測試可能比真正遇到新場次容易。這類資料可以先依活動分組,再切分。若要預測下一學期,亦可用較早資料訓練、較晚資料測試,檢查跨時間的效果。
重點是模擬實際使用情境。隨機分割並非永遠錯,但必須確認它沒有讓相近樣本或未來資訊偷偷進入評估。
看結果時多問三個問題
第一,測試資料代表哪些人與哪些情境?第二,模型在哪一類資料最常失敗?第三,與簡單規則相比究竟改善多少?只看一個總分,容易漏掉少數但重要的失敗。
拿一份手邊的資料,先不訓練任何模型。標記哪些列屬於同一活動、同一使用者或相鄰時間,再設計一個不會偷看答案的切分方式。這往往比急著挑演算法更有價值。
圖解:準確率高,不代表有用
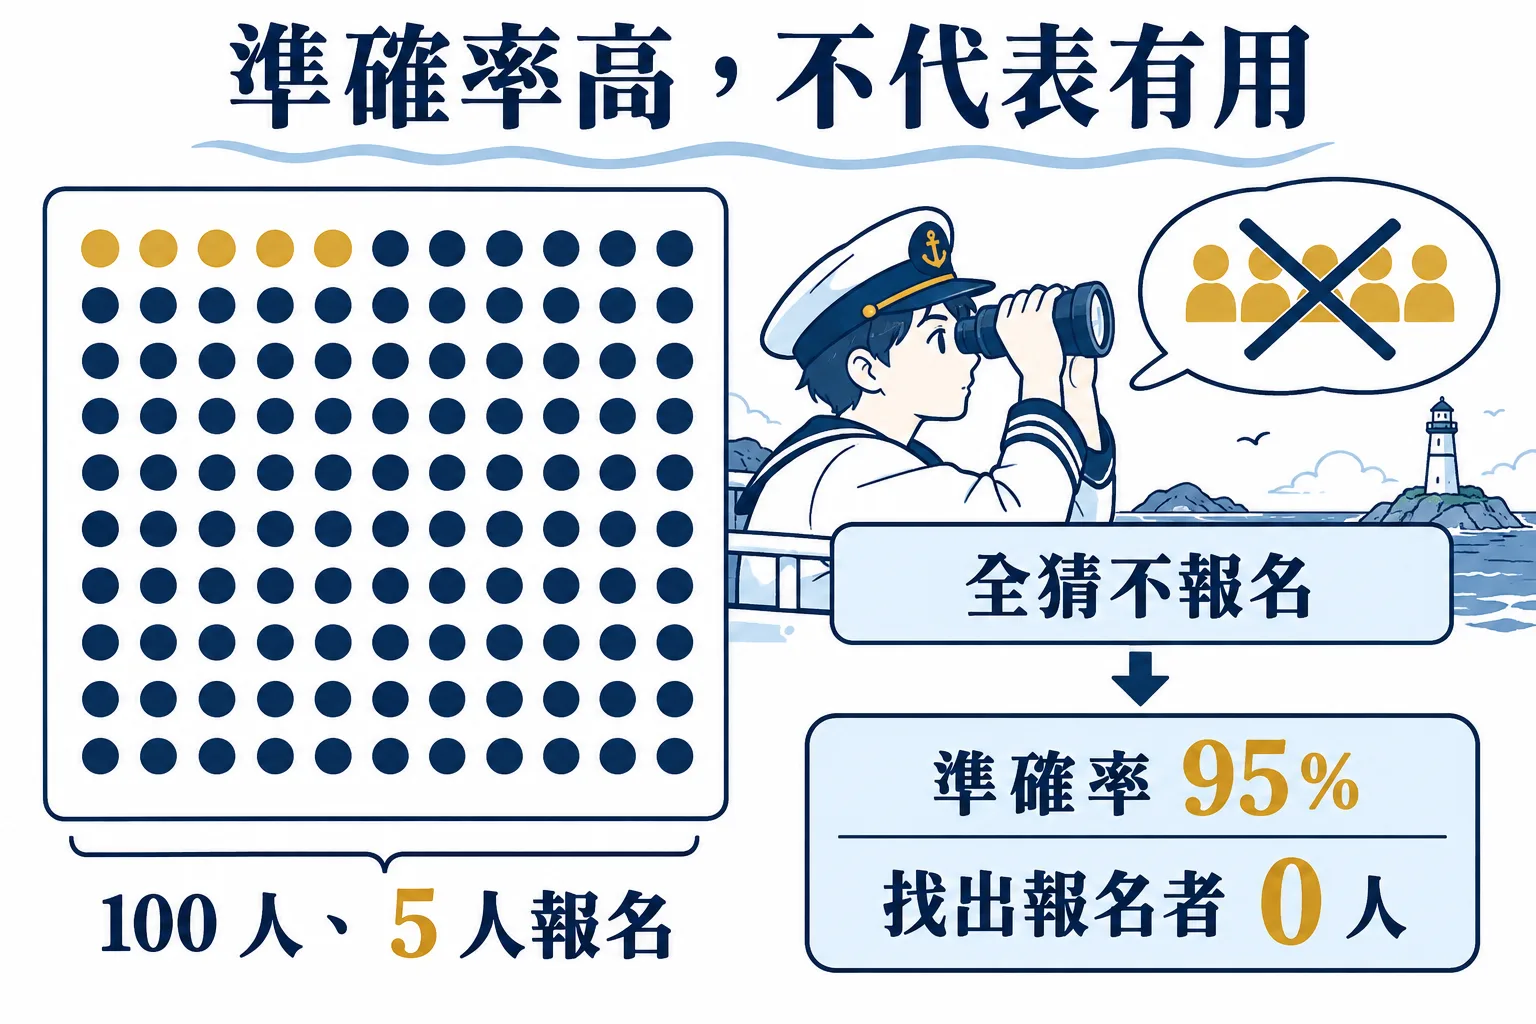
實作案例:為何 95% 準確率仍可能沒有用?
假設教學資料中有 100 位詢問者,只有 5 位最後報名。模型若把所有人都判成「不報名」,整體準確率也有 95%,卻找不到任何真正的報名者。這是示範資料,並非實際招生結果。
因此要同時觀察你想找出的對象。有多少真正報名者被找出,對應召回率;被模型選中的人裡,有多少真的報名,對應精確率。若聯繫名額有限,錯誤邀請會浪費工時;若漏掉有興趣的人,則可能損失機會。選哪個指標,要回到工作的限制。
如何建立一份不偷看的評估紀錄
先用較早的活動訓練、較晚的活動評估,會比隨機混合更接近預測下一場活動的情境。同一人的重複資料應放在同一組;補缺值、標準化等需要從資料學習的處理,也應先在訓練資料上建立,再套用到其他組。
每次記錄資料期間、模型版本、設定與錯誤案例。不要看完測試結果又反覆依它選設定,否則測試集逐漸變成另一個驗證集。需要反覆改善時,保留新的最終評估資料。
練習:用紙筆列出四種錯誤:真報名卻漏掉、未報名卻選中、正確選中、正確排除。替前兩種錯誤各寫一個具體工作成本。
指標定義可延伸閱讀 Google:準確率、召回率與精確率。
行銷名單最容易忽略的資料洩漏
假設你想在活動開始前,預測誰可能購票,卻把活動後才產生的「是否收到票券」欄位放進訓練資料。模型很容易得到漂亮分數,因為答案已經藏在輸入裡。這叫資料洩漏:模型取得了實際做決策時不可能知道的資訊。即使程式沒有錯,評估結果仍會造成誤導。
另一種洩漏來自重複的人。某位會員有五筆互動資料,若其中三筆在訓練集、兩筆在測試集,模型可能只是認出這個人的特徵,而不是學會如何處理真正的新會員。評估時應依實際使用情境考慮按人、按組織或按時間切分,而非永遠隨機分配每一列。準備預測下一季的需求,就應保留較新的資料來模擬未來。
不只看整體分數,也看哪一群人容易出錯
想像一百筆名單中有九十五人不會購票。模型若全部回答「不會」,準確率也有百分之九十五,卻完全沒有找出會購票的人。這是教學情境的假設數字,不是實際活動結果。它提醒我們:高準確率未必等於能支援工作,還要檢查真正被辨識出的目標、誤報與漏報。
誤報代表把沒有需求的人當作有需求,可能浪費聯絡成本;漏報代表錯過原本有需要的人。哪一種錯誤比較昂貴,取決於任務。不要只追求一個通用分數,應先列出工作上的代價,再選擇評估指標。也可以把分數按新舊客、活動類別與時間區間拆開,觀察平均值是否掩蓋了特定情境的失敗。
把測試設計成一份可重做的紀錄
每次實驗保留資料版本、切分方法、模型設定與評估時間。先固定一個簡單基準,再比較新做法是否有改善。若同時換資料、換模型、換判斷門檻,就很難知道差異來自哪裡。測試集也不應被反覆拿來調整細節,否則團隊會逐漸對測試題本本身過度擬合。
部署後仍要抽查新資料。招生季與非招生季、平日與連假、既有產品與新課程,可能存在不同的行為分布。出現分數下降時,先查欄位是否改名、資料是否缺漏與任務是否改變,再決定是否重新訓練。維護模型不只是更新參數,也包含持續確認問題仍然值得用同一種方法解決。